
System design на собеседовании
Как пройти архитектурную секцию: уточнить нагрузку, выбрать очередь и хранилище, объяснить отмену и отказы. Сквозной кейс с расчётами и схемой.
На этой странице
На system design оценивают, как ты превращаешь неопределённую задачу в проверяемое устройство сервиса. Сначала уточни пользователей, операции, объём данных и допустимые отказы. Затем предложи простую схему, проследи один запрос и объясни, что произойдёт при повторе, перегрузке и падении компонента. Названия баз и очередей полезны, когда из ответа понятно, зачем они нужны.
Ниже — маршрут архитектурной секции и авторский кейс сервиса обработки изображений. Это тренировка с заданными числами, а не задание работодателя. Скачай условие, схему, расчёт и проверку модели или открой полный разбор для копирования. Исполняемый пример проверяет арифметику и переходы состояния; реальную пропускную способность кластера он не измеряет.
Что выяснить до схемы
Начни с результата для пользователя. «Обработать изображение» может означать синхронный ответ за секунду, фоновую задачу с уведомлением или пакетную операцию к утру. Эти продукты потребуют разных способов приёма нагрузки. Не выбирай брокер, пока неизвестно, можно ли ждать в очереди.
Уточни размер файла, среднюю и пиковую частоту, длительность пика, срок хранения, правила повторного запроса и доступ к результату. Спроси, какие потери допустимы: отдельное уведомление можно повторить, потерянный оригинал восстановить уже нечем. Если данных нет, предложи явное допущение и попроси подтвердить его.
Реплика кандидата:
Предлагаю асинхронную обработку. После сохранения оригинала и записи задания возвращаем идентификатор, результат читается отдельно. Пока приму один регион, файлы до 8 МБ и хранение 24 часа. Какой срок от приёма до готовности нужен пользователю и сколько он может ждать в пике?
Здесь нет выдуманного SLO. Цель согласуется отдельно, а архитектура затем проверяется на соответствие. Разделяй время ответа приёма, ожидание очереди, обработку и время до доступного результата: быстрый ответ 202 ещё не означает быструю работу сервиса.
Как распределить разговор
В начале уточни условия и запиши измеряемые требования. Затем нарисуй основной путь, пройди один запрос, оцени узкое место и выбери две существенные аварии для подробного разбора. Оставь время на ограничения решения. Если интервьюер переводит разговор к хранению или согласованности, следуй за этой задачей: фиксированный поминутный сценарий не обязателен.
На схеме должны быть понятны границы ответственности. API проверяет пользователя и допустимость входа. Хранилище держит байты. База метаданных хранит владельца, состояние и ссылки на объекты. Очередь сообщает о работе, worker выполняет преобразование. Компонент удаления следит за сроком хранения. Для маленького объёма некоторые роли могут жить в одном процессе; разделение на рисунке не требует отдельных микросервисов.
Условие: обработка изображений
Средняя нагрузка — 10 файлов в секунду. Пик — 100 файлов в секунду на протяжении 60 секунд. Размер файла не больше 8 МБ, средний — 2 МБ. Средний результат занимает 0,5 МБ. Один worker обрабатывает одну задачу за раз и тратит 0,4 CPU-с на файл. Для расчёта каждому worker выделено одно полностью доступное ядро, обработка однопоточная: 0,4 CPU-с соответствуют 0,4 секунды на задачу. Сетевые задержки и I/O в модели отсутствуют. Оригинал и результат хранятся 24 часа.
Пользователь получает HTTP 202 и job_id, запрашивает статус, скачивает готовый результат и может отменить незавершённую задачу. Повторная доставка сообщения возможна. Чужие задания и объекты недоступны. Работа идёт в одном регионе. Нужно предложить схему, рассчитать порядок мощности и хранения, объяснить повтор и гонку отмены с завершением.
Сначала уточни значение средней частоты. В нашем расчёте суточные 10 файлов/с уже включают пики. Добавлять ещё 60 секунд по 100 файлов/с к суточному объёму нельзя: это будет другой профиль. Для отдельного расчёта очереди принимаем вход 100/с в течение минуты и заранее пустую очередь.
Схема и путь одного задания
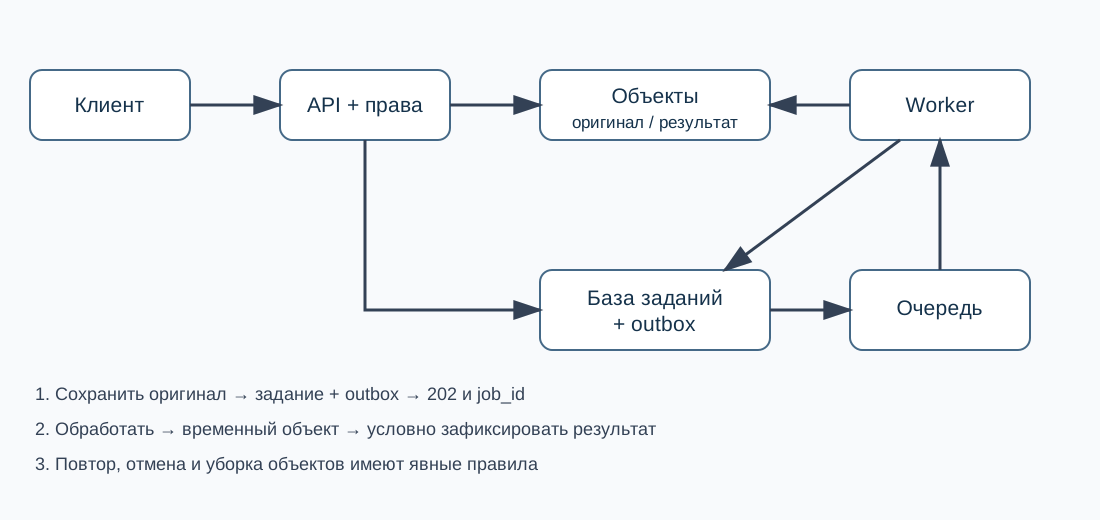
Клиент загружает файл через ограниченный маршрут приёма. Сервис проверяет размер и допустимый тип, сохраняет оригинал под новым объектным ключом. Только после подтверждения сохранения создаёт запись задания и событие outbox в одной транзакции базы. Ответ 202 означает, что запрос принят к дальнейшей обработке; готовность он не гарантирует. В ответе нужны идентификатор и понятный способ узнать статус.
Издатель outbox отправляет сообщение с идентификатором в очередь. При падении после отправки, но до отметки о доставке событие может отправиться снова. Поэтому outbox не избавляет worker от повторов. В очередь не нужно помещать сами мегабайты изображения: достаточно ссылки и данных, необходимых для проверки задания.
Worker получает задание и пытается получить право на обработку. В реальной реализации это может быть аренда с номером попытки и сроком. Потерянная аренда не должна позволять старому worker опубликовать устаревший результат. Он пишет результат во временный объект и условно переводит своё задание в succeeded. Читатель получает ссылку только на объект, зафиксированный в метаданных. Осиротевшие временные объекты удаляются отдельно.
Между object storage и базой нет общей транзакции. Это надо сказать вслух. Возможны сохранённый оригинал без записи задания или временный результат без успешной фиксации. Решение — безопасный порядок действий, повторяемые операции и уборка таких объектов. Писать «всё атомарно» без указания границы транзакции нельзя.
Расчёт мощности и очереди
Один идеальный worker обрабатывает 1 / 0,4 = 2,5 файла/с. На среднем входе четыре занятых worker дают ровно 10/с, на пике сорок — ровно 100/с. Равенство входа и мощности не оставляет запаса на разброс длительности и отказы. Это нижняя модельная граница, а не рекомендация числа реплик.
Если во время пика доступны 20 worker, их идеальная мощность — 50/с. За 60 секунд очередь вырастет на (100 − 50) × 60 = 3000 задач. При возвращении входа к 10/с свободная мощность составит 40/с, и такой хвост уйдёт за 75 секунд. Это приближение поточной модели; оно не даёт точной задержки каждого запроса и не учитывает время масштабирования.
За сутки при среднем входе 10/с принимаются 864 000 файлов. Оригиналы занимают 1 728 000 МБ, результаты — 432 000 МБ: всего 2,16 ТБ в десятичной системе. Это оценка объёма объектов за сутки, без реплик, версий, метаданных и запаса. Если 24 часа отсчитываются по-разному для оригинала и результата, оценку одновременного хранения придётся уточнить. При лимите 8 МБ нельзя планировать пропускную способность только по среднему размеру.
Приложение содержит исходные величины и расчёт в CSV. Команда python3 verify.py проверяет их в Python 3.9 и возвращает ненулевой код при неверной формуле. Изменение пользовательского профиля делается отдельно: верификация зафиксированного упражнения не выдаёт прогноз производительности новой системы.
Отмена, повтор и недоступное хранилище
Для упражнения принимаем состояния pending, running, succeeded, failed, cancelled. Завершённые состояния терминальны. Из running можно перейти в успех, отказ или отмену. Владелец может попросить отмену, но ответ должен говорить, принята ли она: завершённое успешное задание задним числом не становится отменённым.
Отмена и завершение конкурируют за условное обновление одной записи. Если первой зафиксировалась отмена, поздний worker не публикует результат; его временный объект убирается. Если первым зафиксирован успех, отмена возвращает состояние «уже завершено». Удаление готового результата — отдельная операция со своими правилами, если продукт её предусматривает.
Повтор сообщения после успеха должен прочитать терминальное состояние и закончиться без новой публикации. Повтор пользовательского запроса приёма можно связать с ключом идемпотентности и отпечатком входа. Одинаковый ключ с другим файлом требует явного ответа об ошибке, а не молчаливого возврата чужого результата.
Если storage недоступно до подтверждённого приёма оригинала, нельзя отвечать, что файл надёжно поставлен в работу. Если хранилище результата временно недоступно, worker может повторить операцию по ограниченной политике. У повторов нужны пределы, задержки и учёт общей нагрузки; бесконечные немедленные попытки усиливают аварию. Неповторяемые ошибки входа отправляют задание в понятный отказ.
Вопросы с ответами
Зачем очередь, если можно сразу вызвать worker? Она отделяет приём от выполнения и позволяет временно пережить всплеск, если продукт допускает ожидание. Очередь имеет предел ёмкости и времени: она не создаёт вычислительную мощность. При превышении допуска нужен отказ приёма или другой согласованный режим.
Можно ли гарантировать обработку ровно один раз? Для такого разговора полезнее назвать наблюдаемый эффект: один опубликованный результат для одного задания. Повторные вычисления могут случаться, а условная фиксация и идентичность задания не дают повторно опубликовать результат. Это не универсальная гарантия «exactly once» для всех внешних действий.
Зачем проверять владельца при каждом запросе статуса? Непредсказуемость job_id не заменяет авторизацию. Проверка нужна при чтении статуса, отмене и выдаче доступа к объекту. Срок действия подписанной ссылки и возможность её передачи также входят в модель доступа.
Какие метрики назовёшь? Частоту принятых и отклонённых задач, возраст старейшей задачи, распределение времени до результата, ошибки по причинам, число повторов, занятость worker и недоступность зависимостей. Размер очереди без возраста не объясняет, сколько ждёт человек. Среднее время без перцентилей скрывает хвост задержек.
Как кэшировать статус? С учётом владельца, изменения состояния и требований к свежести. Нельзя отдавать персональный ответ через общий кэш без корректных правил. Для терминального результата и меняющегося состояния могут понадобиться разные политики; наличие GET само по себе не делает ответ публично кэшируемым.
Как проверить ответ перед интервью
Пройди сценарии: повтор сообщения, потеря ответа после фиксации, отмена до старта, отмена после успеха, чужой идентификатор, временный отказ storage и истечение срока хранения. Для каждого укажи наблюдаемый ответ, состояние в базе и судьбу объектов. Затем объясни, какое измерение заставит изменить схему.
Не начинай с многострановой репликации, если задача ограничена одним регионом. Углубляйся в риск, который виден из условий: здесь это очередь на пике, согласование публикации результата и отмена. Для подготовки к конкретной роли используй также интервью backend-разработчика — это зависимость совместного выпуска этой партии. В нём подробно разобрано одноразовое действие, а здесь сохранён архитектурный масштаб.
Источники
RFC 9110: HTTP и статус 202, AWS: transactional outbox, Microsoft: retry pattern, MDN: HTTP caching, Google SRE: monitoring distributed systems и Яндекс: подготовка к backend-интервью. Материалы работодателя помогают сверить контекст секции; числа и решение упражнения созданы для этого разбора.