
Портфолио аналитика данных: вопрос, данные, анализ и решение
Полностью воспроизводимый проект аналитика: новый датасет остатков, проверка качества, визуализация и решение.
На этой странице
Портфолио аналитика данных должно показывать, как ты переводишь вопрос в проверяемый расчёт и решение. Для этого нужен законченный проект: определение показателя, исходные данные, очистка, воспроизводимый код, понятный результат и границы вывода. Большой ноутбук с десятками графиков не заменяет ответа на вопрос, ради которого его открыли.
Ниже разобран оригинальный учебный проект о доступности офисных товаров. Скачай данные и код, посмотри исходный CSV и готовый результат. Данные синтетические; это не работа для реального магазина. Такой пример можно изучить, но в собственном портфолио нужно явно назвать источник и свою самостоятельную доработку.
Что проверяют по аналитическому проекту
Читателю важно понять, какую неопределённость ты уменьшил. Ты можешь корректно написать SQL, но посчитать показатель, который не отвечает бизнесу. Можешь найти различие, но не заметить несопоставимые группы. Можешь подготовить полезный расчёт, но спрятать его в файле, который требует восстанавливать чужую рабочую среду. Портфолио связывает эти уровни.
Начни с задач целевой вакансии. Для операционной аналитики подходят качество данных, загрузка процессов, доступность ресурсов, очереди и остатки. Для продуктовой — использование функций, удержание, эксперименты с условиями применимости. Финансовому аналитику потребуется другая модель и другие определения. Один учебный проект не подтверждает готовность ко всем специализациям одновременно.
MIT CAPD связывает отбор работ с профессиональным интересом кандидата. Поэтому не выбирай самый сложный доступный датасет только ради впечатления. Выбирай вопрос, по которому сможешь объяснить каждое допущение. Если работа командная, выдели собственный расчёт, решение и проверку; само присутствие в проекте не раскрывает вклад.
Как сформулировать небольшой содержательный вопрос
В нашем примере команда закупок спрашивает: «Какой товар стоит первым проверить на проблемы пополнения?» Это вопрос для первоначальной диагностики, а не задача автоматически заказать нужное количество. Данных для полноценного управления запасами пока нет.
Доступна утренняя выгрузка за шесть дней по трём товарам: бумаге PAPER, ручкам PEN и папкам FOLDER. В каждой строке есть дата, код товара, начальный остаток, проданные за день единицы и результат контрольного пересчёта. Начальный остаток — снимок на определённый момент, а не гарантия наличия на протяжении всего дня.
Мы выбираем показатель: доля наблюдаемых дней, в начале которых остаток равен нулю. Он помогает найти товар для проверки. Он не измеряет потерянные продажи: неизвестно, сколько людей хотело купить отсутствующий товар, были ли внутридневные поставки и чем покупатели заменяли покупку.
Уже на этом шаге портфолио показывает профессиональное действие. Аналитик ограничил вопрос так, чтобы на него можно было ответить имеющимися данными. Он не обещал измерить весь эффект бизнеса по маленькому файлу. Если заказчику нужен объём следующего заказа, понадобится отдельная постановка с поступлениями, сроками поставки и историей спроса.
Зафиксируй единицу наблюдения
Одна нормальная строка — один товар в один день. Ключ состоит из даты и SKU. Во входном CSV девятнадцать строк данных, но уникальных наблюдений восемнадцать: одна строка полностью повторяет другую. Этот повтор не является дополнительным днём и должен быть учтён как технический дубль.
| Поле | Смысл в учебном проекте | Что нельзя предполагать |
|---|---|---|
date | День утреннего наблюдения | Полная временная история операций |
sku | Один из трёх товаров | Взаимозаменяемость товаров |
opening_stock | Начальный остаток | Наличие на полке в любую минуту |
sold_units | Число проданных единиц за день | Полный неудовлетворённый спрос |
counted_stock | Контрольный пересчёт в условии | Пустое значение равно нулю |
Сохрани определения рядом с кодом. Если появится второй склад, ключ должен включать склад: иначе два корректных наблюдения начнут выглядеть дублями. Если данные приходят по часам, переход к дню потребует отдельного правила агрегации. Изменение детализации нельзя прятать внутри команды удаления повторов.
Как очистить данные и сохранить доказательства
Сначала оставь исходный файл неизменённым. В отчёте укажи девятнадцать входных строк, восемнадцать уникальных и один удалённый точный дубль. Результаты очистки должны позволять восстановить, что именно произошло. Фраза «очистил данные» без количества и правила мало что объясняет.
Скрипт считает допустимым только полностью одинаковый повтор одного ключа. Если у одинаковой даты и товара различаются продажи, он прекращает расчёт с ошибкой. Нельзя автоматически выбрать максимальное значение, последнюю строку или среднее: в условии нет сведений о времени исправления записи. Нужен ответ владельца источника.
У FOLDER в одном наблюдении пустой результат пересчёта. Он сохраняется как пропуск и считается отдельно. Это не мешает вычислить показатель по заполненному начальному остатку, но ограничивает вывод о качестве пересчёта. Если бы пустым был сам начальный остаток, понадобилось бы новое правило знаменателя, а не незаметное превращение неизвестного в ноль.
Документация Python CSV описывает чтение строк и словарей, но не определяет бизнес-смысл пустого поля. Поэтому преобразование типов и проверка условий в примере заданы явно. Для контрольного файла достаточно стандартной библиотеки; подключение большой инфраструктуры не добавило бы достоверности маленькой задаче.
Расчёт, который можно объяснить вручную
Для каждого SKU считаются наблюдаемые дни, дни с нулевым начальным остатком, проданные единицы и пропущенные пересчёты. Затем нулевые дни делятся на число наблюдаемых дней этого товара. Во всех трёх группах знаменатель равен шести.
| Товар | Дней | Нулевой начальный остаток | Доля | Продано единиц | Пропуск пересчёта |
|---|---|---|---|---|---|
| PAPER | 6 | 0 | 0% | 30 | 0 |
| PEN | 6 | 4 | 66,7% | 4 | 0 |
| FOLDER | 6 | 0 | 0% | 12 | 1 |
Ручная проверка: бумага продаётся по пять единиц шесть дней, всего тридцать. Папки — по две, всего двенадцать. У ручек четыре дня с нулевым начальным остатком, затем два дня продаж по две единицы, всего четыре. Продано сорок шесть единиц, но складывать их для решения о конкретном пополнении нельзя без понимания различий товаров и спроса.
Доля для ручек — 4 / 6, округлённо 66,7%. В расчёте хранится отношение, округление применяется при показе. Общая доля нулевых наблюдений — 4 / 18, примерно 22,2%, но она прячет проблему отдельного товара. Если групповые знаменатели разные, простое среднее их процентов может отличаться от доли по всем наблюдениям. В этом проекте для решения нужен разрез по SKU.
Визуализация с понятной задачей
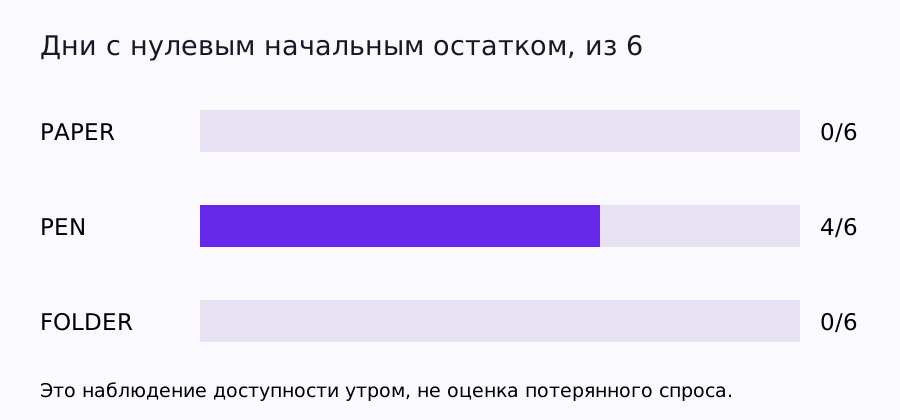
Схема показывает один показатель и одинаковые знаменатели. PEN выделяется четырьмя нулевыми утренними наблюдениями; остальные товары в этом срезе не имеют таких дней. Подпись не называет это «потерей 66,7% продаж», потому что данные такого вывода не содержат.
Microsoft в рекомендациях по дашбордам предлагает начинать с аудитории и решений, для которых нужен экран. Здесь получатель — закупщик, которому нужно выбрать первую проверку. Поэтому один читаемый график и таблица полезнее десяти декоративных диаграмм. Сам пример не является файлом Power BI и не обещает проверенный запуск в этом продукте.
В собственной работе проверь, видны ли подписи на телефоне и понятен ли ноль. Нулевая высота столбца — результат расчёта, а не отсутствие данных. Пропуск пересчёта отмечен отдельным столбцом таблицы, чтобы не смешивать две разные ситуации.
Готовый вывод для портфолио
Короткое резюме проекта может выглядеть так:
«Проверил девятнадцать исходных строк наблюдений, удалил один точный дубль и сохранил один пропуск пересчёта отдельно. У ручек начальный остаток равен нулю в четырёх из шести дней. Предложил сначала проверить график пополнения и сверить движения товара. Потерянный спрос и будущий объём заказа по этим данным не оценивал».
Следующее действие — запросить поступления, списания, время отсутствия на полке и историю спроса за сопоставимый период. Если нулевой остаток возникает после ночного переноса данных, причина может быть в учёте, а не в физическом отсутствии товара. Проверка операционного определения нужна до решения о дополнительной закупке.
Это законченный аналитический результат для своего масштаба: есть ответ, основание, ограничение и следующий шаг. Он не обязан завершаться заявлением о росте прибыли. Для портфолио полезнее точный промежуточный вывод, чем неподтверждённая «экономия компании».
Как повторить проект
В распакованной папке stock-project выполни:
python3 analyze.pyНужен Python 3.9 или новее, сторонних пакетов нет. Скрипт запускает четыре контрольных теста исходного набора. Если хотя бы один тест не пройден, он завершается с ненулевым кодом до записи result.json; ранее сохранённый файл при этом не обновляется. При успехе читает CSV рядом с собой, записывает result.json и печатает расчёт. Контрольный итог: девятнадцать входных строк, восемнадцать уникальных наблюдений, один дубль и сорок шесть проданных единиц.
Для собственного изменённого набора используй python3 analyze.py --analyze-only --csv my-stock.csv. Этот режим выполняет анализ без проверок фиксированных итогов учебного CSV; проверки неотрицательных количеств и конфликта одного ключа сохраняются. Он не подтверждает правильность нового бизнес-вывода: свои ожидаемые итоги и новые правила нужно проверить отдельно.
Четыре проверки охватывают контрольные итоги, добавление точного дубля, пустой набор и конфликтующие записи одного ключа. Они не означают проверку любого возможного повреждения CSV, работы со всеми датами или устойчивости производственного конвейера. Если расширишь входной формат, добавь проверки новых правил.
В руководстве Government Analysis Function качество аналитического кода связано с воспроизводимостью и соразмерной проверкой. Для своего проекта зафиксируй версию языка, структуру файлов, команду запуска и ожидаемый итог. Человек должен иметь возможность проверить результат без доступа к твоему компьютеру.
Что положить в репозиторий и на первую страницу
Сверху размести вопрос и короткий ответ. Ниже — данные, определения, способ расчёта, результат, ограничения и запуск. Исходный CSV и код держи отдельными файлами. Не прячь главную мысль в последней ячейке ноутбука, а ограничения — в комментарии, который никто не увидит.
GitHub описывает README как место, где объясняются назначение проекта и начало работы с ним. В приложенном README.md уже есть контрольные числа и ограничения данных. В собственном проекте добавь происхождение и условия использования реального набора, если работаешь не с самостоятельно созданными данными.
Публичные материалы должны открываться без твоих рабочих учётных записей. Синтетический пример можно публиковать как учебный, но он не становится коммерческим опытом из-за красивого оформления. Если основа чужая, назови её и покажи самостоятельную постановку или проверку, а не только замену цветов графика.
Как связать проект с откликом и интервью
В резюме достаточно короткой записи с ролью, результатом и ссылкой. Подробности вынеси в портфолио: «Разобрал качество данных и утреннюю доступность SKU; подготовил воспроизводимый анализ и ограничения вывода». Для общего оформления опыта используй резюме аналитика данных.
На интервью приготовься объяснить, почему удалил один дубль, сохранил пропуск и выбрал именно такой знаменатель. Покажи, что поменяется при втором складе или пропущенном дне. Не называй наблюдение причинным эффектом. Отдельная подготовка к интервью аналитика помогает разобрать более широкий разговор; этот проект подтверждает конкретный путь от вопроса до решения.